2018年10月10日水曜日

機械学習の重みとバイアス

機械学習の推論結果は確率なので%になります。
画像では単に枠が示されそればレモンであるかテニスボールであるかの表示がありますが値としては%のデータを持っていて%は省略している場合が多いです。
また推論が間違っている場合があります。
この間違えが重要で学習方法が完璧ではなく改善の余地がある事を示しています。もっとたくさんの優良な学習データで長い時間学習すれば正解率は上がります。そこはデータサイエンティストの腕の見せ所です。学習データを選別して不良データを取り除いたりデータをトリミングしたり等です。
機械学習とは機械が自動的に学習する前に人間が良いデータを選別して学習させる事が重要で結構泥臭い部分がある事は案外知られていません。

さて、データはレモンの確率90%テニスボールの確率70%、その確率を決める要素は重みとバイアスです。
重み(weight)は例えば黄色がよりレモンらしいとか質感等よりレモンらしいとかです。ではバイアス(bias)とは何でしょうか?先入観とか偏見といった様に重みの優先順位です。優先順位をつけて推論の確率を決めて行きます。
正方形のレモンはないので色や質感がよりレモンに近くてもレモンの確率が下がります。
球の場合はレモンの確率はそれほど下がらないかもしれません。
要素がレモンにいくら近くてもその要素の優先順位が低ければ確率は下がります。バイアスはその優先順位の様なものです。
      

ライムを学習せずにAIに推論させるとレモンとして確率を表示するでしょう。
ライムを学習させるとライムの確率を表示します。

レモン、テニスボール、ライム等はクラスといいます。AIは学習したクラスに当てはめて推論をして行きます。つまり上記3つを学習したAI の世界はレモンとテニスボールとライムしかありません。
この学習過程は以前の動画をご覧になれば機械学習がどの様に学習して重みやバイアスを決めていくかイメージ出来る思います。
ビデオで言うニューロンとは神経細胞です。


イラストや写真はネットで著作権フリーの素材を探していますが結構気を遣います。

2018年10月5日金曜日

WIO LTEでIoTとクラウド(3)

10月4日
昨日のAWS Solution Day2018でAmazon SageMakerで強化学習が出来そうな事が
わかったので10日にアマゾンの大阪オフィスで詳細を確認するアポイントを取った。

異常検知の方法は2つ
①異常のデータをいくつかのパターンを取ってそれを教師付き学習させる。
②正常データをモデルにして異常データを判別する強化学習。

今回はどんな異常が出るか分からないので強化学習で今回はSageMakerの1つのアルゴリズムである異常検知(Random Cut Forest)を試してみる。

トランスの温度異常を取りながら通常状態を学習する為、室生発電所のトランスの温度のデータを取る必要が出てきた。昨日の講演で、”データを収集し貯めるシステムを確実に作る。”事が重要との話があったので、整理する。
①データを取る条件を合わせる。センサーの種類、温度を測る場所と位置と距離
②日時、パネル種類や枚数、パワコンモデルと台数、天気、気温、日射、発電電力。
予測データを使うか?

データをテキストか温度グラフ等への変換したデータか?
両方を比較する為にどちらが良いか試す。
昨日の公園でもデータの扱い何月何日の購入データか前回の購入から何日かで同じ日の購入のデータの取り扱いが違う。

AIは万能ではないので良質なデータが不可欠。その為のデータ変換を検討する。
取得するデータは多過ぎると解析の負担になるしシステムが複雑になる。ダイキン研究員の講演の様にテストして精査する必要もありそう。

全自動が望ましいが半自動(現地で収集するデータと他で取得出来るデータも考える)
日射、裏面温度や気温はまとめて1つのパラメータにする等の工夫が必要。

2018年10月4日木曜日

AWS Solution Day2018

10月3日
AWSの必要なサービスの選定。
ML(機械学習)のサービスの模索。
ただカタログの表紙のサービスだけでもこれだけある。100以上ある中でどのサービスが最適かは使って見ないと分からない。


今回の興味あるサービスはAmazon Polly(テキスト読み上げーtext-to-speech)
SSML(Speech Syntheis Language)
例えばOVGRが動作したら、ターゲットで確認するのではなくドアを開けると音声で
警告ー”地絡発生中”、”パワコン待機中” 等々で新しいサービスになる?

プラットフォームーAmazon SageMakerが有力
14個のアルゴリズムObjection Detection(物体検知)
異常検知(Random Cut Forest)
https://aws.amazon.com/jp/blogs/news/use-the-built-in-amazon-sagemaker-random-cut-forest-algorithm-for-anomaly-detection/

https://awa.amazon.com/jp/blogs/machine-learning/use
(後日送られるURLで確認)
dockerでフレームワークの持ち込みも可能
エンジンAMI ー Tensor flow等々
インフラ       ー GPU

DAIKIN GLOBAL PLATFORM
各社色々努力してコストの削減とサービスの向上をしている。システムを複雑にしている感がある。

言わずもがなAIも費用対効果が必要。

2018年10月3日水曜日

第2回AIビジネス創出アイデアコンテスト

10月2日
コンテスト参加に向けて内容を検討中。


商工会議所主催のワークショップも既に終わっておりぶっつけ本番なので赤外線を使ったAIで応募要項に沿った内容に出来ないかを工夫する必要がある。
今年の夏はグーチョキパーを各5000枚のデータを取って学習のモデリングをして
コリントゲームの玉をグーで勝てば1つ、チョキで勝てば2つ、パーで勝てば3つ打ち出す展示をしたのでこれを応用する事で小野さんと相談予定。
科学の祭典で子供に理解し易い展示を目指したので、ここを今回の趣旨に変更する事で開発期間を短縮する。
しかしながらモデルを作り込む時間がないのでモデルは現状で見せ方に工夫を考えて機材をiPhoneとESP-WROOM-02からXavier(若しくはTX2)とPi Zeroで有線接続に変えてJECA FAIRで無線LAN接続で不安定になった経験から確実な展示をめざす。

小野さんと打合せが必要(10月19日予定)

コンテストは自由課題へ変更
社長へのデモは10月末で11月8日の事前相談会12月7日17時必着

具体的な内容はこれから整理する。

2018年9月30日日曜日

AIの本質

英語ですが動画でとても正確な説明をしているサイトがありました。
一冊の本を読むよりこの動画を眺めて下さい。
イメージを掴めれたら良いです。

https://youtu.be/aircAruvnKk


一番有名な0から9までの手書きの数字を学習して推測するまでの過程が
説明されています。基本的な説明で今はこの考え方は古くなっていますが初心者の理解にはとても良い説明です。
チャピター3まで視聴出来れば良いですが、多分眠たくなるでしょう。
13002通りの計算を手書きの数字を学習する際に計算で重みとバイアスを記憶していって新しい手書きの数字を0−9のどれかの推測をします。実質98%位の確率です。
5000位のサンプルを13002回計算しますが要は0−9かどうかの計算なので5000X13002回=65010000回CPU計算するよりGPUで5000の並列処理で13002回計算する方が効率的です。
この点と点の結びつきや重みやバイアスが脳神経科学によるものでこれをコンピュータでシミュレートするのがAIです。
画像認識、音声認識等ほぼ同じ様な工程で認識して推測すると思って頂いて良いと思います。

数式のイメージを分かりやすく説明すると%Zで事故電流を求めたりインピーダンスマップからそれぞれの継電器の制定値を求めたりするのと同じです。要はオームの法則で数値を求めるだけです。インピーダンスがあるので一見難解に思う様に見ると理解し易いのではと思いますが如何ですか?

openCV make file ②(忘備録)

9月29日14時
コピペやGUIに慣れると直ぐに嵌ります。Orz...
cdで目的のディレクトリーに行けない。思い込みと基本がなってない。覚えたつもりで入力しても間違えてるし。
cd ~/でどこにいくのかcdファイル名とコマンドの直後のスペースの意味。理解したつもりだとなにを間違ったのか分からない。
まずlsコマンドとls /でディレクトリーの確認をして思い込みを無くして。作業に慣れる。これコマンド操作の基本。

make fileの作業手順
①ターミナルの起動後コマンドでmkdir hello作業用ディレクトリーhelloを作る。(既にディレクトリーがある場合は②から)
②lsコマンドもしくはls /コマンドでディレクトリーの確認でhelloが表示されるか確認。
③cd helloで作業用ディレクトリーに移動
④pwdでどこに居るか念の為確認する。
⑤g++ -o aaa aaa.cpp `pkg-config --cflags opencv` `pkg-config --libs opencv`で実行ファイル生成
-o オプション+スペース+実行ファイル名 でa.out でなく自分の好きな実行ファイル名を付けられます。

念の為もう一つ例:g++ -o main main.cpp `pkg-config --cflag opencv` `pkg-config --libs opencv`
⑥作業ディレクトリーで./aaaで実行
例
若しくは一つの例./mainで実行

 `pkg-config --cflags opencv` `pkg-config --libs opencv`の意味


これをコンパイルするときには,(1)cv.hなどのOpenCVのヘッダファイルが何処にあるのかの指定と,(2)libcvなどのOpenCVのライブラリが何処にあるのかの指定が必要です.これらを勝手にリストアップしてくれるのがpkg-configというコマンド.
まず,(1)のヘッダファイルについては
pkg-config --cflags opencv
を実行することでリストアップできます.僕の環境では
-I/opt/local/include/opencv
となりました.次に,(2)のライブラリについても同様に
pkg-config --libs opencv
を実行することでリストアップできます.僕の環境では
-L/opt/local/lib -lml -lcvaux -lhighgui -lcv -lcxcore
となりました.これをg++に引数としてソースコードと一緒に渡してやればコンパイル出来ますです.
g++ -o main main.cpp -I/usr/include/opencv -L/usr/lib/opencv -lcv -lhighgui
ここで,pkg-configの結果を直接g++に渡したいものです.そこで登場するのが`(バッククオート).コマンドを`で囲むと,その部分が,そのコマンドを実行した結果に置き換わります.つまり
g++ -o main main.cpp `pkg-config --cflag opencv` `pkg-config --libs opencv`
と書けばOK.
毎回こんな長いコマンドを打つのはやってられないので,Makefileに
main: main.cpp
     g++ -o main main.cpp `pkg-config --cflag opencv` `pkg-config --libs opencv`

と書いてやれば,makeコマンド一発でコンパイル出来ます.
もうちょっと洗練して
main: main.o
     g++ -o $@ $< `pkg-config --libs opencv`
.cpp.o:
     g++ -o $@ -c $< `pkg-config --cflags opencv`
とかくとなおよし.

2018年9月27日木曜日

今後のタイムスケジュール

9月27日
少なくとも年内は基礎的な事に時間を頂きます。作業日誌的な内容になる事が多くなりますが、我慢下さい。

12月初め期限の商工会議所のAIコンペは意識していますが、10月末に出れるか結論を出すつもりです。

AIのハードウェアは既に決まっています。まだ使いこなせないのにこんなの買いました。

開発者用の販売で最新のXavierを入手しました。もうトヨタは自動運転の自動車のテストしていると思いますがこれを積んで開発中だと思います。


AIを搭載したロボット、自動車や機器として開発商品化している主な会社は
トヨタ、ヤマハ、任天堂等々 ー 大多数はnvidia(時価9兆円)と共同開発
              (私がインストールしたCUDA等で開発されています。)
日産            ー Google
(カルソニックも含めてAIの開発の話は聞いた事がない。)            
フォルクスワーゲン、BMW ー     Intel 

ソフトバンク(孫正義氏)が3.3兆円で買収したARM、Qalcomm(携帯やスマホの通信部分のと3G、4G、5Gの特許の多数を所有)、アップル、マイクロソフト等も何かしら出てくると思います。中国も近年侮れないです。テンセント(中国のグーグル)は実力は日本以上です。

今、自社でXavierで何か出したらこの業界では注目される位凄いものです。
商工会程度のAI作品ならこれ使ってるだけで審査員が凄いって思う位のものです。

自動運転をAIで開発する事が進んでいますが、一般に入手可能なハードは一択でNVIDIAのjetsonシリーズのTX2かXavierだけです。インテルMovidius(単体では動かずラズベリーパイLinuxかパソコンのUSBに刺して使うGPUです。)がありますが、非力(TX2の1/5程度)です。ラズベリーパイLinuxに元からあるGPUより早いですが、今年そのラズベリーパイのGPUに最適化されたデモではほぼ同じ位の能力でインテルも大した事はない印象。

グーグルはハードは未定です。おそらくXavierを使うと思います。
インテルは2000年初頭に車載機器で失敗しています。ハードが専用設計で開発者が手を出せないのでまた失敗すると思います。

今回FLIRに一緒に掲載された小野さんはNVIDIAの開発には定評があり、ブログの閲覧履歴もTOYOTA,TOSHIBA,PANASONICのドメインからのアクセスがある位です。
TX2はほぼ環境は出来ていますが私が操作する為、基本的な事を今教えてもらっています。9月10日に先行発売されたXavierは現在環境構築中です。

年内に社内でXavierで何らかのデモの予定です。ただXavierは価格が2499ドルなので高額でTX2(8万円位)でもAIで何かデモ出来ないか検討中です。
性能差と価格差の比較ですが、XavierはGPUの性能は今の私の母艦パソコン並その1/10がTX2それでも凄かったのですが。。。(過去形)
トヨタ工場の搬送システムはAIにTX2が採用されています。
因みに任天堂のスイッチ(今CMで流行りのゲーム)にはNVIDIAのtegraというTX2の2世代前の技術が使われています。アーキテクチャはTX2とほぼ同じです。
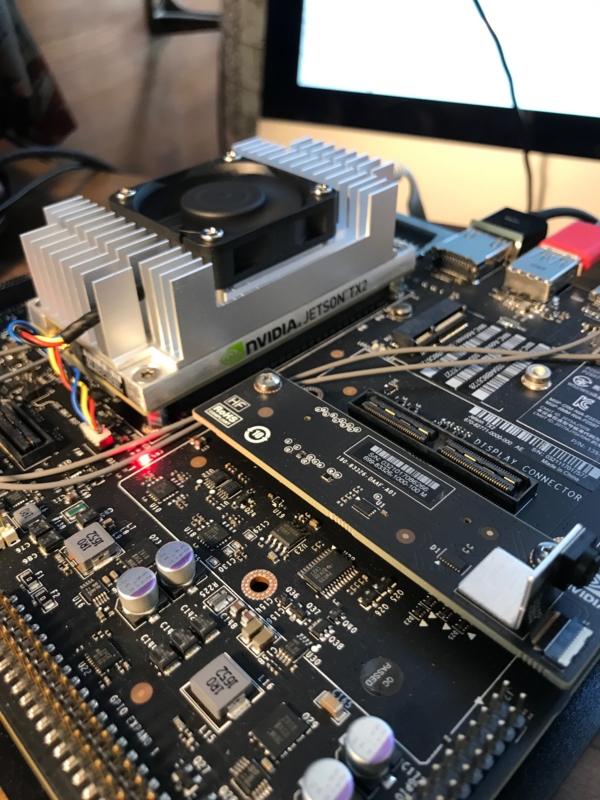
オリジナルのTX2マザーボード付き(大きすぎる!)
Xavierの値段1/3で能力1/10
これをマザーボードを小型Linux機に乗せ変えて基盤自作してバッテリー駆動に改良!
smockParticlesシミレーションが30FPS位

性能差と価格比のイメージを分かりやすく説明すると、TX2(10万円のパソコン)とXavier(200万円のワークステーション)位の差で分かります?

タイムスケジュールと目標ですが、来年2月末の準備期間後XavierでAI開発が出来る様にしたいと思っています。makefileのコマンド関係はやはりすぐには理解出来ない。2日掛かってほとんど進捗なしに等しいです。
プログラマーになろうとしているのではないですが、ある程度理解しないとサンプルプログラムも実行ままならないです。